홈페이지 통계 화면을 열면 "유입 경로 1위"가 바로 보입니다. 검색이 1위면 검색 노출에 더 힘을 쓰고 SNS가 1위면 글을 더 자주 올리자는 판단으로 이어지기 쉽습니다. 그런데 그 숫자가 어떻게 세어졌는지는 화면에 적혀 있지 않습니다.
저희는 9월에 올린 글에서, 조회수만으로는 글이 읽혔는지 알 수 없어 열람·완독·다음 행동을 나눠 기록하기로 했다고 썼습니다. 이번 글은 그다음 이야기입니다. 그 세 숫자를 글마다, 들어온 곳마다 직접 모으기 시작했고 점검에서 숫자가 조용히 틀리는 경우를 네 번 찾아 고쳤습니다. 화면에는 오류가 없었고 숫자도 그럴듯했습니다. 틀린 줄 모르고 볼 수 있는 종류였습니다.
통계를 보고 판단하는 운영자나 외주로 만든 사이트에 통계를 붙이려는 분이 개발사에 물어볼 질문으로 쓰실 수 있게 정리했습니다.
글마다, 들어온 곳마다 직접 세기로 했습니다
열람·완독·다음 행동의 정의와 본문 끝 표식 이야기는 앞 글에 있으므로 여기서는 되풀이하지 않습니다. 달라진 것은 그 세 숫자를 어디에 어떻게 쌓느냐입니다. 10월 초 이틀 동안, 글마다 조회·끝까지 읽음·상담 버튼 클릭을 어디서 들어왔는지와 함께 하루 단위로 자체 데이터베이스에 모으게 했습니다.
모으는 범위는 좁게 잡았습니다. 개인정보는 받지 않습니다. 들어온 곳도 주소 전체가 아니라 검색, SNS, 다른 사이트 같은 종류로만 나눕니다. 로봇의 방문과 없는 글의 주소는 세지 않고 한 탭에서 같은 글의 같은 지표는 한 번만 셉니다. 개발 중에 눌러 본 것이 섞이지 않도록 운영 사이트에서만 기록합니다.
보는 쪽은 두 군데입니다. 관리 목록에는 최근 30일의 조회·완독·주요 유입을 글마다 한 줄로 보여 주고 글 편집 화면에는 날짜별 30일 표와 출처별 표를 둡니다. 출처별 표에는 조회·끝까지 읽음·상담 버튼 열이 따로 있습니다. 어느 출처에서 많이 왔는지보다, 어느 출처에서 온 독자가 끝까지 읽고 상담까지 가는지가 보고 싶었기 때문입니다.
실제로 모으는데 개인정보처리방침에 그 사실이 없으면 안 되므로, 방침을 10월 3일자 1.8판으로 고쳐 자체 방문 집계 한 줄을 넣었습니다. 거부 방법까지 적어야 하는지 같은 법적 최종 판단은 아직 남은 과제입니다.
기록이 아무리 쌓여도 합계가 끝까지 더해지게 했습니다
첫 번째는 합계입니다. 데이터베이스는 서버를 보호하려고 한 번에 보내 주는 개수를 정해 둡니다. 저희가 쓰는 데이터베이스 서비스는 기본값이 1,000줄입니다. 여기서 1,000은 방문 수가 아니라 날짜·글·지표·출처별로 나눠 저장한 집계 줄의 수입니다. 방문이 많지 않아도 글과 출처가 늘면 30일치 줄은 금방 이 개수를 넘습니다.
그래서 30일 합계처럼 많은 기록을 더할 때는 묶음을 나눠 끝까지 이어 받아야 합니다. 점검에서 이 부분을 확인해 보니 첫 구현은 첫 묶음까지만 더하고 있었습니다. 이 제한은 오류를 내지 않아서 화면에는 그럴듯한 숫자가 찍힙니다. 빈 묶음이 나올 때까지 이어 받아 더하도록 바꿔, 기록이 얼마나 쌓이든 합계가 끝까지 더해지게 했습니다.
9월 26일 로봇 방문 집계에서도 같은 부분을 손본 적이 있습니다. 한 곳을 고쳐 두어도 새로 만드는 집계에서는 같은 확인을 다시 해야 한다는 것을 이번에 다시 확인했습니다.
같은 점검에서 하나 더 걸렸습니다. 기록을 받는 주소에 받는 양의 제한이 없었습니다. 한 곳에서 짧은 시간에 너무 많이 보내면 그대로 쌓이는 구조여서 그런 경우는 기록하지 않게 했습니다.
어디서 왔는지는 생각보다 어려운 질문이었습니다
두 번째는 출처 판단입니다. 독자가 검색에서 글 하나를 열고, 그 글에서 관련 글을 눌러 두 번째 글로 넘어갔다고 해 보겠습니다. 두 번째 글의 출처는 무엇이어야 할까요. 처음 만든 집계는 이렇게 사이트 안에서 다른 글을 보다 넘어온 경우를 출처로 제대로 잡지 못했습니다.
그래서 출처를 "이 글을 연 직전 출처"로 정하고 독자가 사이트에 처음 들어온 페이지를 기억해 두었다가 사이트 안에서 넘어온 경우를 구분하게 했습니다.
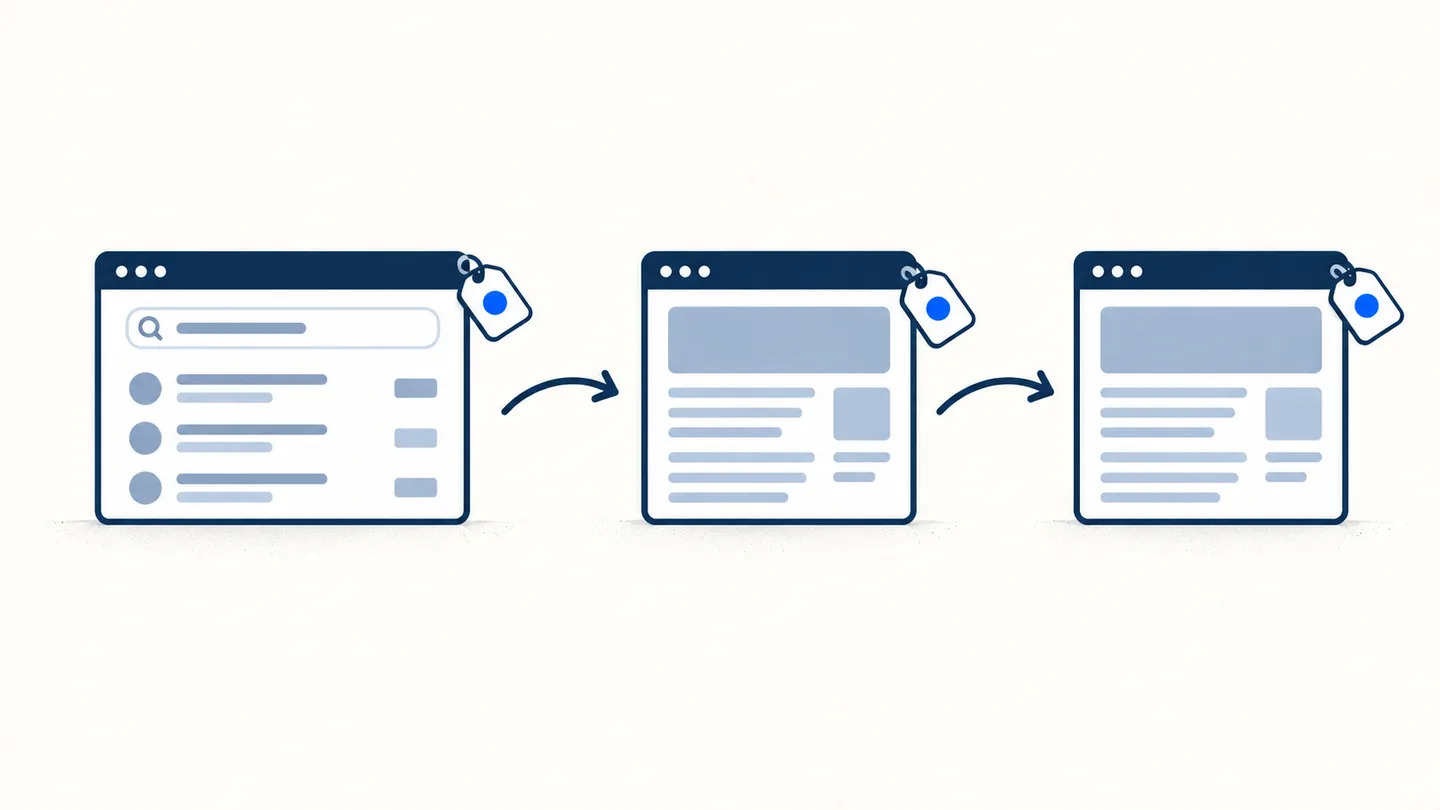
고치는 중에 다시 걸렸습니다. 검색에서 글 목록으로 들어와 그다음에 글을 여는 순서가 있는데, 이 경우를 어떻게 셀지 정해 두지 않아 의도와 다르게 잡혔습니다. 또 하나는 새로고침과 뒤로가기였습니다. 글을 읽다 새로고침을 하면 기억해 둔 출처가 처음 들어온 바깥 주소로 덮였습니다. 그러자 같은 글인데 조회의 출처와 완독의 출처가 서로 달라졌습니다. 출처별로 완독 비율을 보려고 만든 표인데, 이 상태로는 표가 맞지 않습니다. 새로고침과 뒤로가기는 출처를 덮지 않게 바꿨습니다.
최근 30일이 실제로는 31일이었습니다
세 번째는 기간입니다. 화면에 "최근 30일"이라고 적어 두었는데 실제로 더한 날짜는 31일이었습니다. 오늘을 포함해 30일로 세도록 바로잡았고 목록의 수치가 하루치만큼 줄었습니다.
하루치 차이는 작아 보입니다. 다만 다른 도구의 30일과 나란히 놓고 비교하거나 지난달과 이번 달을 견줄 때 기준이 하루 어긋나 있으면 그 차이가 어디서 왔는지 알 수 없습니다. 기간은 숫자가 아니라 정의입니다. "최근 30일"에 오늘이 들어가는지, 어제까지인지는 물어보지 않으면 알 수 없습니다.
통과하던 테스트가 아무것도 증명하지 못했습니다
네 번째는 테스트입니다. 집계에는 테스트가 붙어 있었고 통과했습니다. 그런데 점검에서 보니 그 테스트는 사실상 아무것도 증명하지 못하고 있었습니다. 집계가 틀려도 통과하는 테스트였습니다.
통과하는 테스트를 보면 안심이 됩니다. 그 안심에 근거가 있는지 확인하는 방법은 하나뿐이었습니다. 일부러 고장을 내고 테스트가 실패하는지 보는 것입니다. 집계가 틀린 상태를 만들어 두었을 때 테스트가 빨간불을 켜야 비로소 그 테스트를 믿을 수 있습니다. 이번에는 그렇게 확인했습니다.
남은 한계와 개발사에 물어볼 질문
고치지 못한 것도 적어 둡니다. 출처 분류가 넓습니다. 웹메일이나 일부 블로그에서 온 방문이 '검색'으로 묶입니다. 10월 2일부터 고친 내용이 배포되기 전까지 쌓인 기록은 사이트 안 이동이 첫 유입으로 많이 잡혀 있고 지난 기록을 다시 고치지는 않았습니다. 그리고 아직 30일치가 쌓이지 않아 결과 숫자가 없습니다. 어느 출처에서 온 독자가 끝까지 읽고 상담까지 가는지는 모인 뒤에 이 글에 덧붙일 수 있을 것입니다.
네 가지에는 공통된 성질이 있습니다. 화면은 멀쩡하고 오류도 없는데 숫자만 조용히 틀린다는 점입니다. 통계 화면을 받는 쪽에서는 알아차릴 방법이 없으므로, 받기 전에 물어보는 수밖에 없습니다. 외주로 만든 사이트에 통계를 붙이거나 이미 붙어 있는 통계를 보고 판단하신다면 아래 질문을 그대로 쓰셔도 됩니다.
- 기록이 많이 쌓여도 합계가 끝까지 더해지나요? 데이터베이스가 한 번에 보내 주는 개수를 넘는 경우를 확인하셨나요?
- 사이트 안에서 다른 글로 넘어간 경우 출처는 무엇으로 잡히나요? 새로고침이나 뒤로가기를 하면 출처가 바뀌나요?
- "최근 30일"에 오늘이 들어가나요? 실제로 더해지는 날짜 수는 며칠인가요?
- 로봇의 방문과 개발 중에 눌러 본 것은 빠져 있나요?
- 테스트가 있다면, 일부러 고장 냈을 때 실패하는 것을 보셨나요?
- 무엇을 모으는지가 개인정보처리방침에 적혀 있나요?
답이 바로 나오지 않아도 괜찮습니다. 저희도 점검을 하기 전에는 이 질문들에 답할 수 없었습니다. 질문을 받고 확인해 보겠다고 하는 개발사라면 그것으로 충분합니다.